COLUMN
AI-OCRのハルシネーション対策|お届け先マスタの誤判定を防ぐ技術
「注文書の届け先をAIで自動照合させたが、名寄せエラーやハルシネーション(嘘)が怖くて結局人間が全件確認している」――1番目の類似候補を信用してはいけない構造的原因と、2段階のLLM評価パイプラインで自動化精度を極限まで引き上げるノウハウを解説します。
記事本文
「AIやベクトル検索を導入して、注文書の届け先住所を自社マスタと照合するようにした。しかし、結果一覧の1番上に表示されたデータをそのまま正解にして自動連携することは恐ろしくてできない……」
受注入力や出荷業務の自動化を進める中で、多くのエンジニアやDX担当者がこの壁に突き当たります。
得意先からの注文書には、表記ブレや誤記、あるいは「移転・引っ越し直後でデータが未更新」といった表記が日常茶飯事だからです。さらに厄介なことに、最新の生成AI(LLM)であっても「ドンピシャの正解が候補内にあるのに見落とす(AIの気まぐれ)」や「もっともらしい嘘(ハルシネーション)をつく」という現象が発生します。
今回は、現場の泥臭い課題を解決し、お届け先照合の自動化精度を安全に引き上げるための「ダブルLLM再評価パイプライン」のアーキテクチャを公開します。
1. なぜ「近似値トップ1」をそのまま採用すると危険なのか?
マスタデータとの照合において、従来の完全一致検索はもちろん、あいまい検索やベクトル検索(Embedding)のスコア最上位をそのまま正解データとして採用することは不可能です。
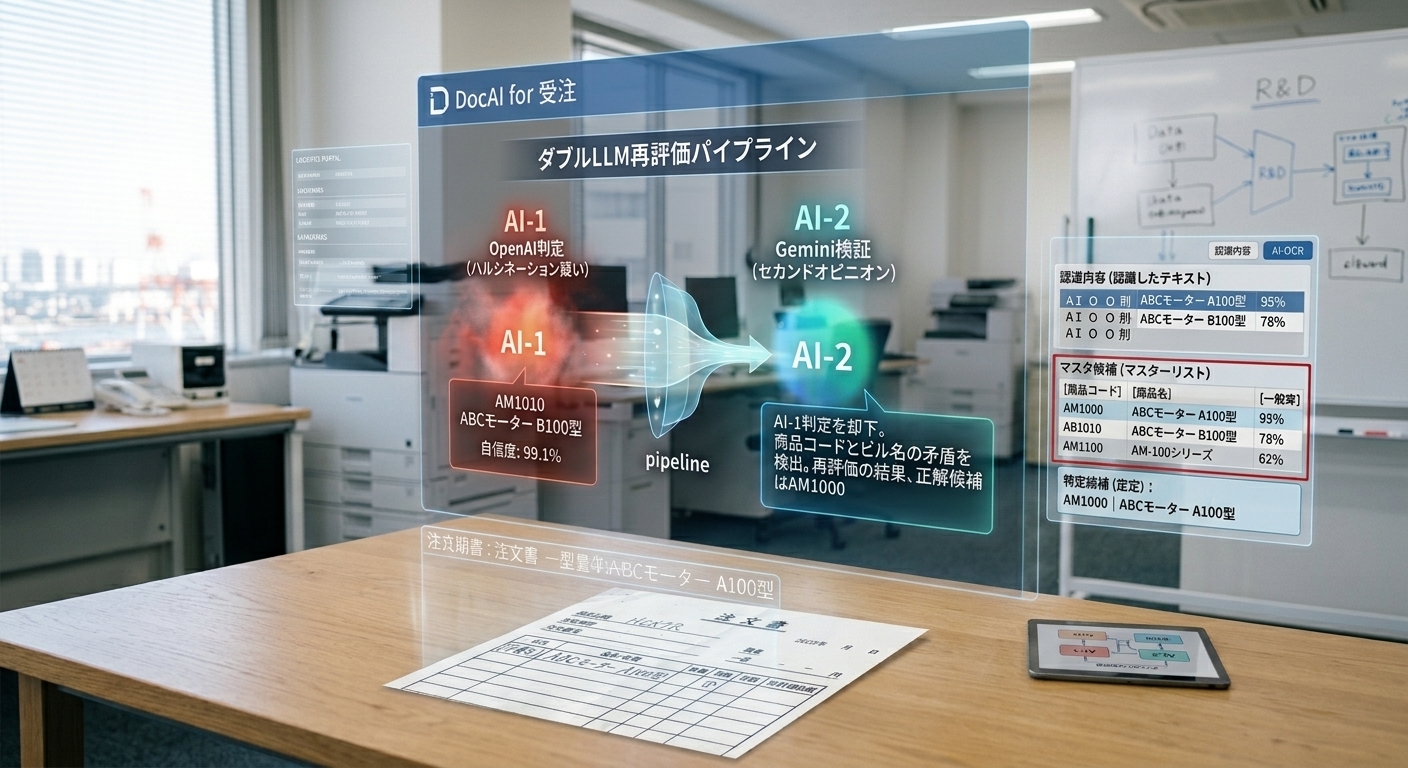
現場で起きる「誤表記」「引っ越し」と「信用失墜」のリスク
実際の注文現場では、以下のようなデータが日常的に飛び込んできます。
- 得意先によるビル名や部署名の省略、漢字の誤記入
- 相手先のオフィス移転や新設に伴う、旧住所と新住所の混在
- 類似した名称の別拠点(例:「〇〇営業所」と「〇〇物流センター」)
もしスコア最上位の誤ったマスタデータをそのまま後続の出荷システムに流してしまうと、誤配送が発生します。誤出荷が一度でも起きれば、納品先からの信用失墜、緊急再配送のコスト発生、ライン停止に伴う賠償トラブルなど、会社の信頼を大きく揺るがす事態に直結します。
実務上は水際チェックで止める運用を挟みますが、それでは「AIを入れたのに人間が全件確認・修正する」という本末転倒な人件費コストが残り続けます。
2. 生成AI(LLM)単発でも防げない「AIの気まぐれ」と「ハルシネーション」
「マスタ検索の最上位が使えないなら、AI(LLM)に直接判別させればいい」と考えがちですが、LLM単体を盲信するのも極めて危険です。
実務で検証を重ねると、LLMには以下のような現象が発生することが分かります。
- 自作のハルシネーション(嘘の判定): 候補の中に正解が存在しない場合でも、それっぽい理由(Reason)を作り上げて存在しないマスタIDを正解と主張する。
- AIの気まぐれ(ゆらぎ): 候補一覧の中に「ドンピシャの正解」が含まれているにもかかわらず、確率論的な出力ゆらぎによって正解を見落とし、自信度の低い別の候補を選んでしまう。
単発のLLM呼び出しに依存したシステムは、このような「AIの気まぐれ」が発生した際に判定精度が暴落し、現場に混乱をもたらします。
3. 精度を高めるノウハウ:近似値Top20抽出 × ダブルLLM再評価パイプライン
これらの課題を克服し、実用に耐えうる自動照合を実現するために構築されたのが、以下の**「近似値Top20抽出 + ダブルLLMアンサンブル評価」**の処理パイプラインです。
最初からLLMに全マスタを渡すのではなく、データベース側でハイブリッド検索を行います。ベクトルの類似度検索(pgvector)とキーワード検索(BM25)を組み合わせ、表記ブレや誤記を含めた上位20件の「正解候補ディクショナリ」を絞り込みます。
抽出した20件の候補と注文書の届け先情報をメインLLM(OpenAI)に投入し、「一致する要素を1つだけ返却し、その判定根拠(Reason)と自信度スコア(Confidence)」をJSON形式で出力させます。
【判定ロジック 1】
Confidenceが0.9未満の場合は「信用できない」と判断し、この判定を即座に保留(次のステップへ送出)します。
1回目の評価で確信度が得られない、あるいは「AIの気まぐれ」が疑われる場合、別のモデルアーキテクチャを持つサブLLM(Gemini)に対して同じ候補データを与え、セカンドオピニオンを求めます。
【判定ロジック 2】
両方のLLMのConfidenceが共に0.8以上であり、かつ「選んだマスタコードが一致」した場合にのみ、自動確定(OK)として後続処理へ連携します。一致しない場合や閾値未満の場合は、人間の目視確認キューへ回します。
「AIに騙されない仕組み」が業務自動化のROIを最大化する
AIやLLMは「100%正しい答えを返す魔法の箱」ではありません。特に届け先マスタ照合のように、間違えた場合のリスクが大きい業務においては、**「AIはハルシネーションを起こすし、気まぐれで正解を外すこともある」**という前提に立ったパイプライン設計が必須です。
一見すると複雑な二段階評価(マルチLLM)を組むことで、誤出荷のリスクを物理的に遮断しつつ、人間が確認すべき「本当に危険な案件」だけを抽出できるようになります。結果として、確認工数の大幅削減と業務の信頼性向上を両立させることが可能になります。
💡 注文書自動化(AI-OCR)の全体像を知りたい方へ
課題選定からPoC・型番補正・現場定着までの全手順を体系的にまとめた【製造業・卸売業】注文書自動化(AI-OCR)完全ガイドもぜひあわせてご覧ください。
楠元 俊二 (Shunji Kusumoto)
中小企業診断士 / 株式会社シジャム・ビーティービー中小企業診断士として、商社・卸売業の注文書入力業務の課題に着目し、「マスタ照合・自動コード化エンジン(DocAI for 受注)」を開発。各企業の取引特性に応じた伴走支援を行っています。
注文書データ化・マスタ照合の精度でお困りですか?
「AI-OCRを導入したがマスタ照合でエラーが頻発する」「住所の表記ブレやハルシネーション対策に頭を悩ませている」という企業様へ。実際の帳票データを用いた無料検証(PoC)を実施中です。